Intel Ungkap Kemampuan GPU D Series Berbasis Crescent Island untuk Pemrosesan AI
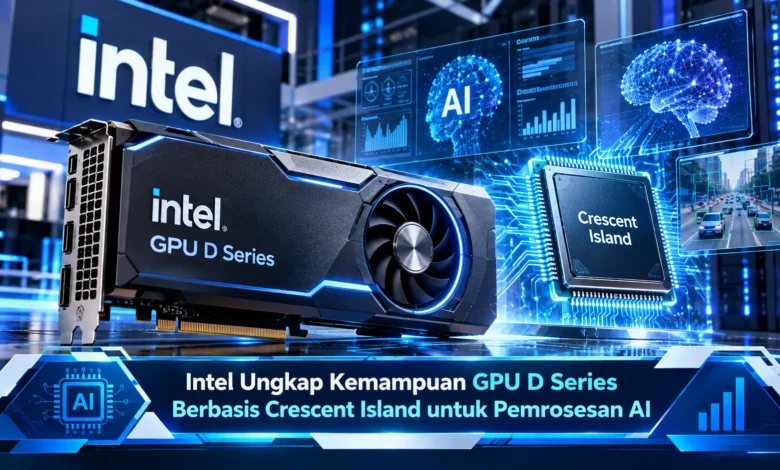
Intel memperkenalkan rincian terbaru GPU D Series berbasis arsitektur Crescent Island dalam ajang Open Compute Project Global Summit pada 12 Oktober 2026. Akselerator ini dirancang khusus untuk kebutuhan pemrosesan kecerdasan buatan atau AI inference di pusat data, dengan kapasitas memori hingga 480 GB LPDDR5X, bandwidth 1,5 TB/s, serta performa komputasi mencapai 1,3 petaflops FP8. Berbekal arsitektur Xe3P dan konsumsi daya yang dirancang berada dalam batas 350 watt, Intel berupaya menghadirkan teknologi pemrosesan AI yang lebih efisien. GPU D Series juga ditujukan untuk menjalankan model bahasa besar, sistem agen AI, dan berbagai layanan inferensi berskala perusahaan.
Pengumuman Intel GPU D Series Perkuat Persaingan Akselerator AI
Pertumbuhan ekosistem pemrosesan data modern memperbesar permintaan perangkat keras khusus AI. Di tengah perkembangan model bahasa besar, pengelola pusat data menghadapi tantangan berupa biaya pengoperasian perangkat keras. Dalam upaya memperluas portofolio produknya, Intel mengumumkan GPU D Series sebagai platform GPU yang dioptimalkan untuk inferensi. Akselerator terbaru tersebut sebelumnya dikenal dengan nama kode Crescent Island yang pertama kali diungkap pada Oktober 2025. Melalui pengumuman terbaru, Intel memberikan gambaran spesifikasi yang lebih lengkap.
Pengenalan akselerator Crescent Island terbaru dilakukan dalam Open Compute Project Global Summit 2026. Forum teknologi tersebut mendorong pengembangan standar perangkat keras dan perangkat lunak. Produsen semikonduktor tersebut mengarahkan GPU D Series sebagai solusi inferensi AI yang efisien. Tidak seperti GPU yang difokuskan pada permainan, perangkat ini difokuskan pada aplikasi kecerdasan buatan. Oleh sebab itu, spesifikasi produk tidak sebaiknya dibandingkan langsung dengan GPU gaming. Arah desain tersebut memberikan alternatif dalam pengembangan infrastruktur AI.
Kemampuan Crescent Island dalam Mendukung Inferensi Berkapasitas Besar
Fitur penting dari Intel GPU D Series adalah dukungan memori LPDDR5X sebesar 480 GB. Dukungan memori besar ini mendukung pemrosesan data inferensi yang intensif. Dalam rincian teknisnya, Intel menjelaskan kecepatan transfer memori sebesar 1,5 terabita per detik. Bandwidth tinggi membantu mengurangi hambatan akses data. Untuk pemrosesan jaringan saraf modern, pemindahan data sering menentukan tingkat efisiensi. Walaupun spesifikasinya menjanjikan, kecepatan inferensi dipengaruhi perangkat lunak dan beban kerja.
Pada aspek arsitektur GPU, GPU D Series mengandalkan teknologi grafis Xe3P yang dirancang untuk pemrosesan paralel. Perusahaan menjelaskan, perangkat ini memiliki kemampuan puncak sekitar 1,3 PFLOPS pada format FP8. Representasi angka floating point delapan bit memungkinkan operasi tertentu menggunakan data lebih ringkas. Akan tetapi, angka teoretis tidak selalu tercapai pada seluruh pekerjaan. Di samping kemampuan komputasinya, GPU menggunakan rancangan daya 350W. Rancangan tersebut mendukung pengoperasian pusat data yang lebih terukur.
Cara GPU D Series Memproses Operasi Matriks Kecerdasan Buatan
Rancangan pemrosesan Intel Xe3P menjadi fondasi utama GPU D Series. Melalui rincian arsitektur yang tersedia, Crescent Island menggunakan 32 inti Xe serta sebanyak 256 mesin matriks XMX. XMX merupakan akselerator yang menangani perhitungan matriks. Dalam kecerdasan buatan, perhitungan numerik membutuhkan pengolahan matriks dalam jumlah besar. Dengan karakteristik tersebut, dukungan XMX menjadi bagian penting dari akselerasi AI. Melalui penggabungan Xe core dan XMX, GPU D Series dirancang menangani pemrosesan model secara berkelanjutan.
Pada tahap menghasilkan keluaran dari model, GPU harus melakukan sejumlah operasi numerik. Aktivitas komputasi tersebut memerlukan koordinasi antara unit pemrosesan dan memori. Rancangan inti GPU bersama unit XMX membantu menangani perhitungan AI. Meski unit komputasi telah dioptimalkan, hasil akhir dipengaruhi pengoptimalan operator AI. Ketika model tidak dioptimalkan untuk arsitektur GPU, pemanfaatan unit komputasi dapat kurang optimal. Karena alasan tersebut, optimalisasi perangkat lunak diperlukan untuk mencapai performa terbaik.
Kapasitas Pemrosesan LLM dan Agen AI pada Infrastruktur Intel
Fitur utama dalam rancangan GPU D Series adalah pemrosesan jaringan saraf dengan parameter sangat banyak. Dalam penjelasan produknya, Intel mengungkapkan bahwa kapasitas perangkat memungkinkan pemrosesan model sekitar 300 miliar parameter. Dukungan tersebut ditunjang ruang penyimpanan bobot yang luas. Namun demikian, penggunaan memori dapat berubah menurut metode kuantisasi. Tidak hanya untuk menyimpan jaringan saraf, memori digunakan bagi cache dan proses pendukung. Karena itu, penerapan produksi membutuhkan pengujian beban kerja.
Ketika satu kartu belum mencukupi, Intel menawarkan pendekatan multi-GPU. Berdasarkan spesifikasi resmi, konfigurasi delapan GPU D Series dirancang mendukung model dengan lebih dari satu triliun parameter. Penggunaan banyak akselerator mendukung pembagian pekerjaan pemrosesan. Ketika perangkat dijalankan bersama, efisiensi bergantung pada pembagian model serta transfer data. Karena alasan tersebut, penggandaan jumlah GPU belum tentu menggandakan kecepatan. Walaupun membutuhkan pengaturan teknis, pendekatan multi-GPU dapat membantu kebutuhan perusahaan.
GPU D Series Dirancang untuk Pusat Data dengan Pendingin Udara
Di samping kemampuan komputasi tinggi, Intel mengutamakan kompatibilitas dengan infrastruktur dalam lingkungan pusat data perusahaan. Perangkat ini dirancang dengan bentuk kartu PCIe standar yang ditujukan untuk pemasangan pada server kompatibel. Intel juga mengandalkan mekanisme air cooling. Pilihan rancangan ini mendukung penggunaan pada rak server konvensional. Walaupun tidak mensyaratkan pendingin cair khusus, perencanaan pendinginan pusat data masih diperlukan.
Pada pengelolaan server perusahaan, investasi awal hanya sebagian dari pengeluaran. Penggunaan listrik, pendinginan, dan pemeliharaan berpengaruh terhadap biaya jangka panjang. Dengan batas daya 350 watt, Intel berusaha menghadirkan keseimbangan antara performa dan efisiensi. Namun demikian, biaya inferensi harus dinilai dari performa sistem menyeluruh. Di samping kebutuhan listrik, dukungan driver tetap perlu diperiksa sebelum penerapan.
Masa Depan Akselerator Intel Berbasis Xe3P untuk Pusat Data
Perkembangan produk Intel untuk kebutuhan inferensi menunjukkan langkah penting dalam industri akselerator kecerdasan buatan. Dengan memanfaatkan teknologi pemrosesan Xe3P, memori hingga 480 GB LPDDR5X, jalur memori dengan bandwidth besar, dan performa hingga 1,3 petaflops FP8, Intel menargetkan kebutuhan inferensi berskala besar. Rancangan daya 350 watt bertujuan mempermudah integrasi infrastruktur. Walaupun spesifikasinya menarik, efisiensi operasional membutuhkan pengujian pada aplikasi produksi.
Saat pengumuman tersebut disampaikan, Intel menyatakan proses customer sampling sedang berlangsung. Namun demikian, waktu distribusi komersial masih memerlukan konfirmasi. Perusahaan turut mengembangkan ekosistem perangkat lunak terbuka bersama penyedia infrastruktur AI. Berkat pengembangan ekosistem, GPU D Series berpotensi menjadi alternatif dalam pasar inferensi. Menurut pandangan Anda, apakah kapasitas memori besar GPU D Series mampu meningkatkan persaingan industri AI? Sampaikan pandangan Anda mengenai masa depan GPU Intel untuk AI.